Projekt részletei
Lokális Observability Stack Infrastructure as Code használatával
Egy reprodukálható monitoring környezet, amely Prometheus, Grafana, Loki és Grafana Alloy segítségével gyűjti és jeleníti meg az infrastruktúra- és alkalmazásmetrikákat, valamint a naplókat. A teljes, négy virtuális gépből álló stack egyetlen vagrant up paranccsal indul - kézi konfiguráció nélkül.
Projektáttekintés
Egy AWS-alapú monitoring demót alakítottam át teljesen lokális, reprodukálható környezetté. Míg az eredeti megvalósítás felhőinfrastruktúrát igényelt, ez a változat bármely, VirtualBoxot és Vagrantet futtató gépen elindítható.
Egyetlen vagrant up paranccsal négy virtuális gép épül fel. A rendszer metrikákat és naplókat gyűjt, webshop-forgalmat szimulál, valamint riasztást küld, ha a lemezhasználat átlép egy meghatározott küszöbértéket. A teljes kiépítés kézi konfiguráció nélkül történik.
Architektúra
A környezet négy Ubuntu 24.04 virtuális gépből áll, privát hálózaton:
| Szerver | IP cím | Funkció |
|---|---|---|
| app-server | 192.168.56.10 | Node Exporter + Grafana Alloy + Titan Flask app |
| prometheus | 192.168.56.11 | Prometheus Server |
| loki | 192.168.56.12 | Loki Server |
| grafana | 192.168.56.13 | Grafana: vizualizáció és riasztáskezelés |
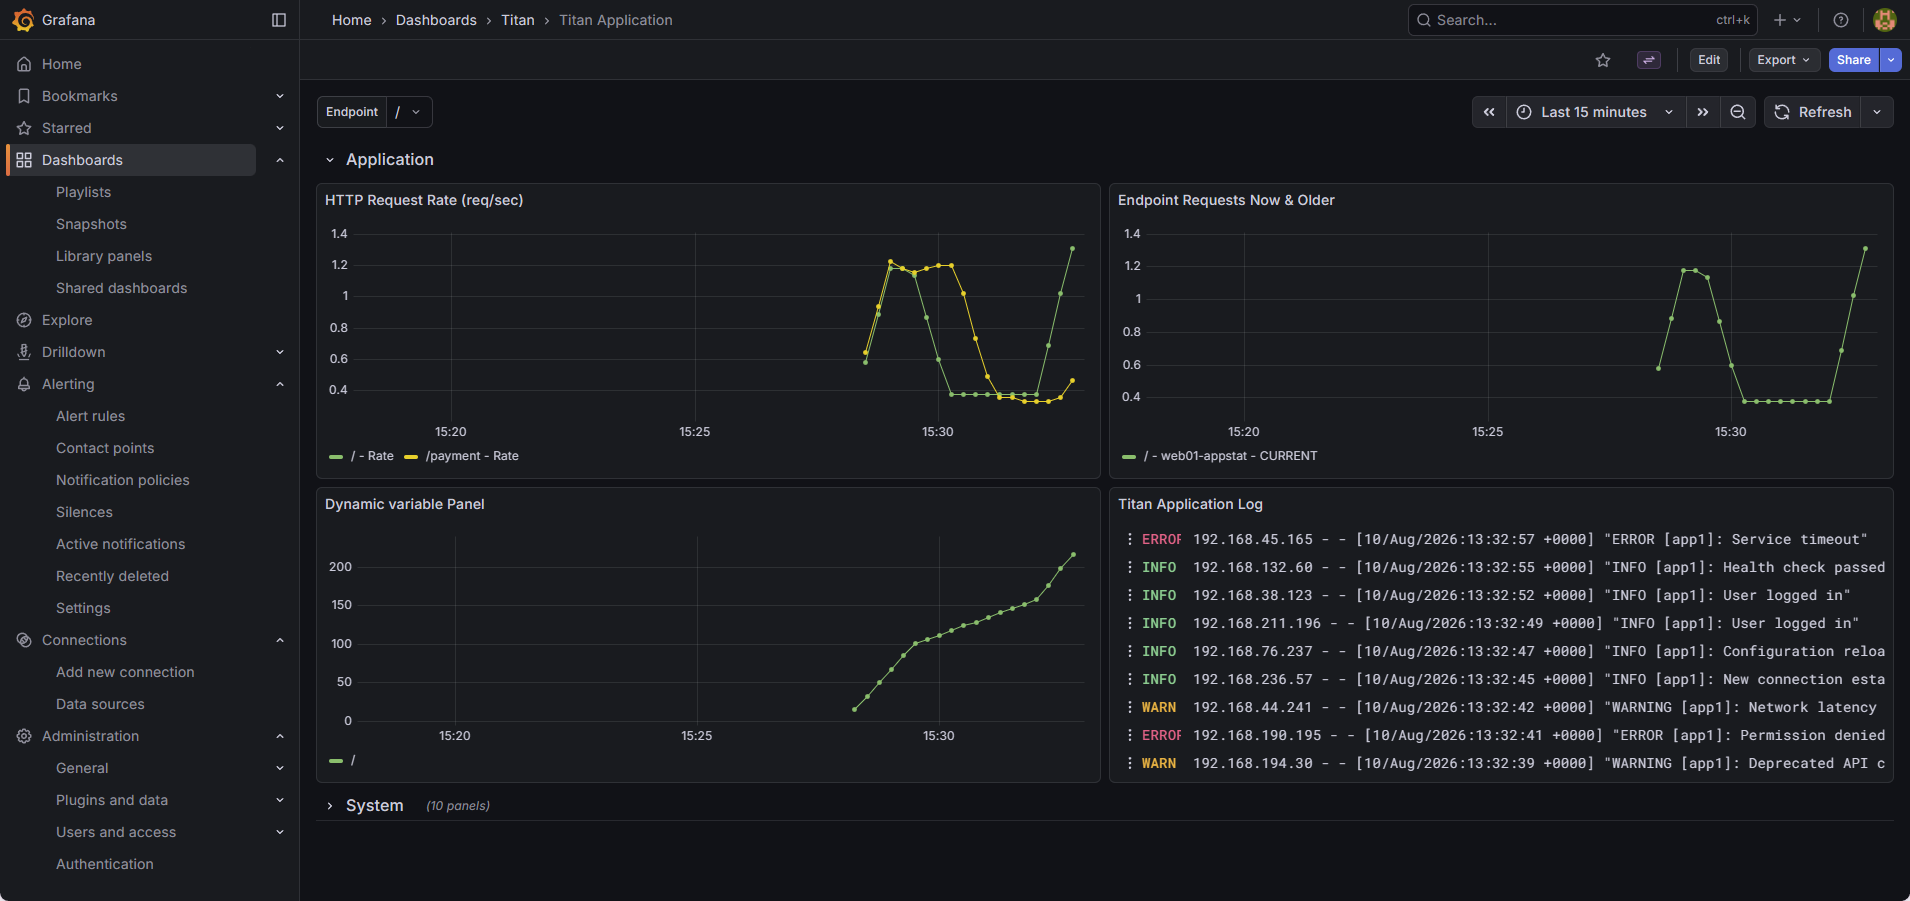
Metrics pipeline: A Node Exporter rendszerszintű metrikákat biztosít, a Grafana Alloy pedig begyűjti az alkalmazás /metrics végpontján elérhető egyedi metrikákat. Az adatokat a Prometheus tárolja, a Grafana pedig megjeleníti.
Log pipeline: A Grafana Alloy összegyűjti a Titan alkalmazás és az operációs rendszer naplóit, majd továbbítja őket a Loki felé. A naplók a Grafana felületén, a metrikákkal együtt kereshetők és elemezhetők.
A Grafana dashboardjai és adatforrásai automatikusan, fájlalapú provisioning segítségével épülnek fel.
Megvalósított funkciók
Infrastructure as Code - A teljes stacket Vagrantfile és shell scriptek építik fel. A virtuális gépek hálózati beállításai, csomagtelepítései és szolgáltatáskonfigurációi verziókezelt fájlokból jönnek létre.
Metrikagyűjtés - A Node Exporter CPU-, memória-, lemez- és hálózati metrikákat exportál. A Grafana Alloy az alkalmazás egyedi Prometheus-metrikáit is gyűjti, például a http_requests_total és http_request_duration_seconds értékeket.
Naplóaggregáció - Az Alloy feldolgozza az alkalmazás access- és errorlogjait, illetve a rendszerlogokat, majd Loki-ba továbbítja őket. A Grafana közös felületen teszi lehetővé a metrikák és naplók vizsgálatát.
Grafana konfiguráció mint kód - Az adatforrások, dashboardok, riasztási szabályok, értesítési csatornák és notification policy-k YAML- és JSON-fájlokból töltődnek be. A Grafana állapotának törlése után egy szolgáltatás-újraindítással a teljes konfiguráció visszaállítható.
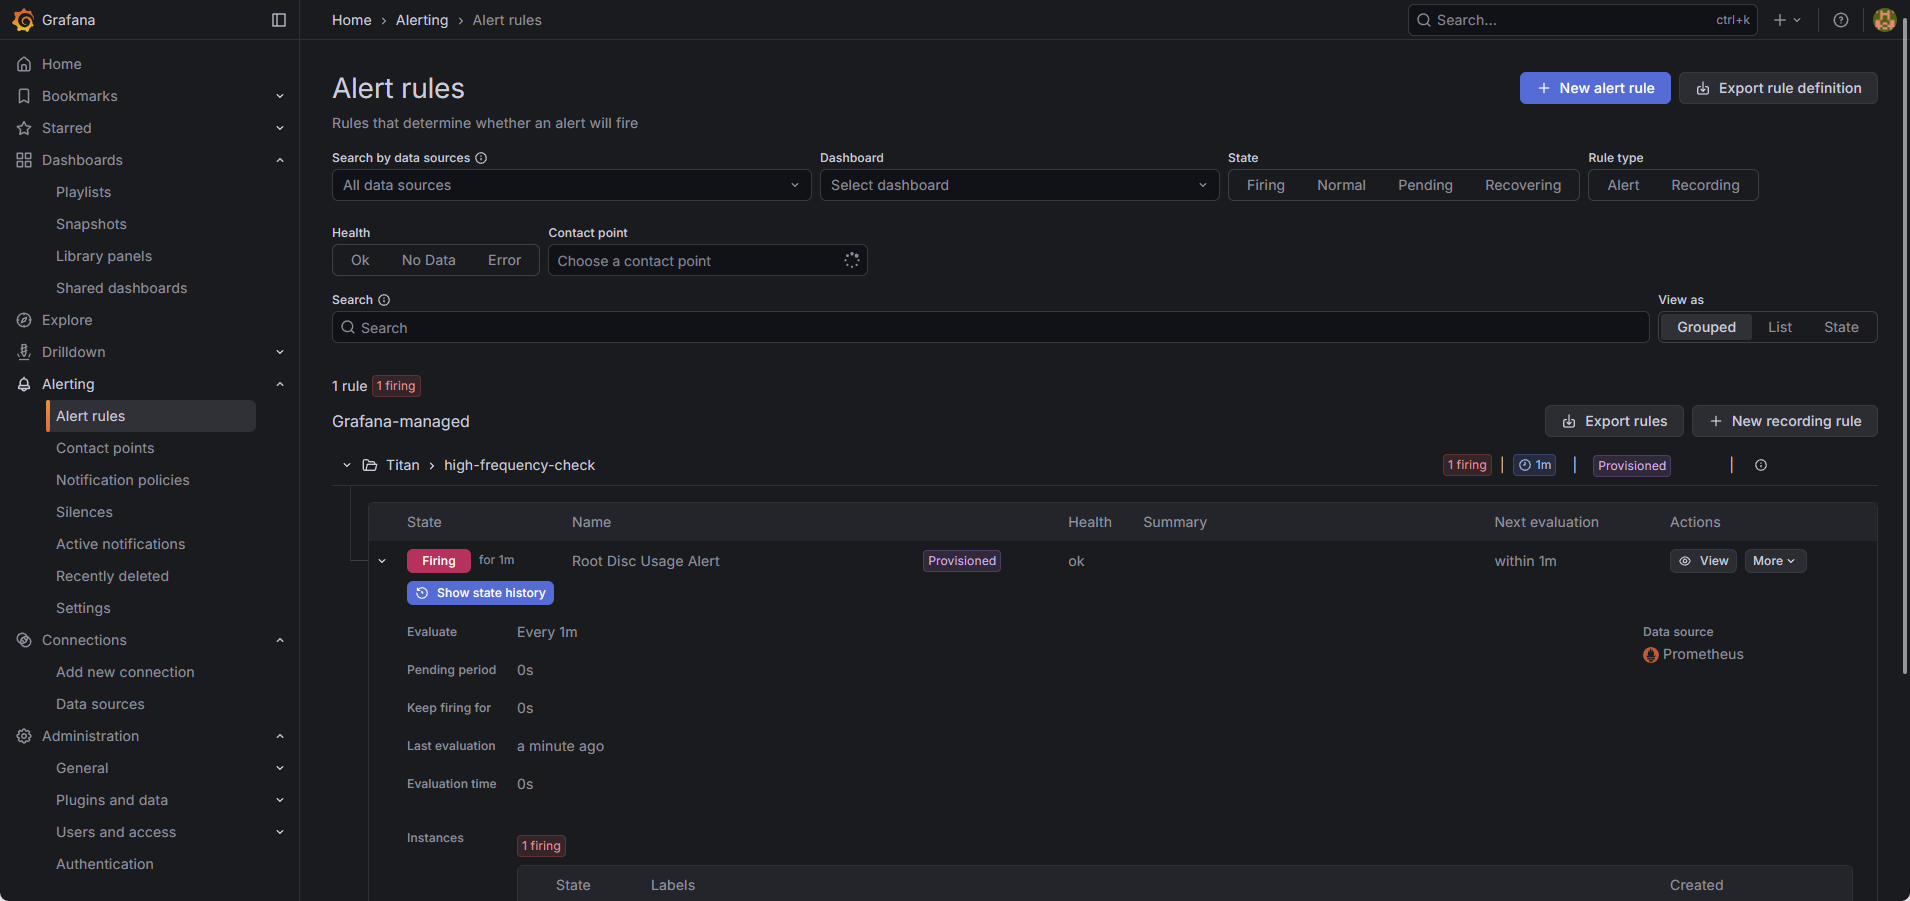
Riasztási szimuláció - Egy crontab-alapú lemezfeltöltő szkript 20 percenként aktiválja a DiskUsageHigh riasztási szabályt 65%-os lemezhasználat felett. Ez egy valós riasztási folyamat tesztelését és bemutatását szolgálja.
Webshopforgalom szimulációja - A Titan Flask alkalmazás két végpontot szolgál ki: / és /payment. Háttérfolyamatok folyamatos kéréseket generálnak, ezért a dashboardok mindig élő alkalmazásadatokat jelenítenek meg.
Megoldott kihívások
Grafana dashboard provisioning és datasource UID-k - A dashboard JSON-fájlok adatforrás-hivatkozásainak meg kell egyezniük a provisioning YAML-fájlokban definiált UID-kkal. Ennek összefüggése a dokumentációban nem volt kellően hangsúlyos, ezért teszteléssel validáltam a működő konfigurációt.
Windows CRLF és Linux LF sortörések - A Windows alatt létrehozott shell scriptek CRLF sortörése miatt a VM-ekben bad interpreter hiba jelent meg. A problémát .gitattributes használatával, egységes LF sortörések beállításával oldottam meg.
AlertingFileV1 konfigurációs struktúra - A Grafana alerting provisioner nem fogad el önálló JSON-tömböt: az alertszabályokat az AlertingFileV1 struktúrába kell csomagolni. A megfelelő fájlformátum beállításával a riasztási konfiguráció is teljesen automatizálhatóvá vált.
VirtualBox és Hyper-V kompatibilitás Windows 11-en - A VirtualBox host-only adaptere és a Hyper-V egyes konfigurációkban ütközhetnek. A helyi fejlesztői környezetben a Hyper-V kikapcsolása oldotta meg a problémát; ez környezetfüggő beállítás.
Használt technológiák
Vagrant - virtuális gépek és hálózati konfigurációk deklaratív kezelése
Prometheus - pull-alapú metrikagyűjtés és idősoros tárolás
Grafana - dashboardok, vizualizáció és riasztáskezelés
Grafana Alloy - egységes agent metrikák és naplók gyűjtéséhez
Loki - központosított naplóaggregáció és lekérdezés
Node Exporter - operációs rendszer szintű metrikák exportálása
Titan / Flask - Prometheus-metrikákkal instrumentált webshop-demóalkalmazás